预算三万内,最高不超过五万。
求大佬推荐机器型号和配置 🙏🏻
求大佬推荐机器型号和配置 🙏🏻
 |
1
RTX 6000 48G *8, 免强能跑 4.1, context 只能稳定在 256K
|
 |
JerningChanOct 20
2
哈哈哈哈,那可以跑个 qwen3.8-27b 4bit 量化。。。
你随便一张 5090 都多少钱了? 4090 那些 22g 的 2080ti ,也能跑,但是就相对慢一点,而且上下文不太够 |
 |
LGZzzzOct 20
3
bilibili 搜本地部署有很多视频讲本地部署这个事. 本地部署恼火.
|
 |
ioriluOct 20
4
3 万看买内存够不够
本地玩说实话没十几万别折腾没意义, 尤其你还想靠这个赚钱的话 比如配一个专业显卡, 至少 72G, 这卡可能现在就要十万, 再加几万买内存, 至少 256G |
 |
faker5276Oct 20
5
新出的 NVIDIA RTX Spark 能跑 4.1 吗?
|
 |
GavinZZOct 20
6
3 万内可以买那个 amd ai max 495 或者 395, 395 稍微便宜点,跑 qwen3.8 27B 还是挺流畅,40tps ,v4.1 flash 吃点力,参数量大,跑个量化版也能跑
|
 |
kerwin1874Oct 20
7
一张 rtx pro 6000 都十几万了,几万预算建议去租机器玩,或者玩玩 qwen 3.8 27b 这种图一乐让它写写黄书还是可以的
|
 |
8
|
 |
duanxianzeOct 20
9
搁这做梦呢??你加两个 0 都不够
|
|
duanxianzeOct 20
10
@faker5276 不能 也只能跑 qwen 3.8 27b 这种
|
 |
penisulaSOct 20
11
我现在 m2max 96G 就能跑 q2 量化的 deepseek v4 flash ,4.1 变大了很多,qwen 3.8 flash 能跑 q4 量化的
|
 |
koicOct 20
12
13 万啊,得是 Mac Studio M5 Ultra 256G 16T(30+64 核)台式机 Z1U5000DG ;就这也不到 100 tok 吞吐啊,你再低配就只有 20-35 tok 了
|
 |
juzisangOct 20
13
qwen 3.8 27b 这种小模型,雷霆大思考,思考过程能占满上下文...根本没法用
 |
 |
AIgogoOct 20
14
预计年底前后这些硬件会降价一波.....
|
 |
sunmacarenasOct 20
15
dgxspark 没涨价之前 128G 的 3 万以内可以搞定,能跑 qwen3.8-next-flash-NVFP4 的模型
|
 |
BeforeTooLateOct 20
16
DeepSeek v4.1flash 本地部署还要流畅,我感觉 50w 都不一定行
|
 |
HakuOct 20
17
两台 RTX SPARK 应该可以拿下 dsf4.1
|
 |
codehzOct 20
20
要跑 200tok/s 这种实用速度的话预算至少乘以 100 才行,否则只能是乌龟爬
|
 |
pnczk2019Oct 20
21
试过几次。感觉本地部署就是自己找罪受。
|
 |
wenxueywxOct 20
22
之前测试 H20 跑 Qwen3.8-Flash ,结论: 短输入、短任务、低并发:快。长上下文、多会话并发等待长,体验差
|
 |
qiuhangOct 20
24
3 万就别想了,加两个 0 差不多。实在要跑,跑个 qwen3.8 27b, 去阿里云租点边角料的抢占式实例,一天 50 来块。跑点黄文,黄土,黄片什么的的也不是不行。如果用来写代码,真不如把 3 万拿去买商业 llm 套餐,能用好几年呢。
|
 |
25
@wises #23 你这张 5060 Ti 能干嘛?出来搞笑的吗= =
|
 |
26
@cjkcjkcjk 你要用 strata 这样的推理工具,比呆呆的用 ollma.cpp 这些更好点。我当前这个配置大概每秒最少达到 80tokens 稳定,某些情况下能达到 100 多 tokens,按照人的阅读速度每秒超过 60tokens,那就反应不过来了。
另外你要说清楚你有几个人并发, 这个很重要,直接关联到硬件的配置。 另外我让 claude 刚给你评估了下跑你这个精度需要硬件配置,供你参考, 我的是丐板,所以内存加不上去。  |
|
wisesOct 20
27
@mzotw2babm 你要多看看刚出来的 strata,16G + 大内存可以跑不少东西了。
|
 |
wudayeOct 20
28
我的配置给你参考一下:3k 的 8 核 32GB 迷你主机+4k 的魔改 3080 20GB 显卡+600 块钱的外接显卡坞,跑 Qwen3.8 27B 量化模型的速度是 55tok/s
|
 |
azhangbingOct 20
30
https://github.com/Niko1221/Strata
2080ti 小超频+ 64GB DDR4 3200 12600k 的主机 跑 Swift Q3S 的速度是 60t/s 256kb 上下文 |
|
31
|
 |
pxlxhOct 20
32
你要是能跑的话 那些卖 token 的不是得头埋裤裆里面
|
|
mzotw2babmOct 20
33
@wises #27 被你打懵了。你 26 楼的回复,图片中写的正常跑 Q2_K 要 512G 内存+32G 显存。你是说你的 48G 内存+16G 显存就能跑?
|
|
wisesOct 20
34
@mzotw2babm 是的,我这是 2 台机器,并不是一台。 我自己这台 itx 小机箱/小主板,可以跑 q2, 我嫌弃精度不够,强行升级到 q3 了,内存估计爆了,准备等内存回来卖掉,上最少 96G 或者 128G 上线。
|
|
wisesOct 20
35
@mzotw2babm 这么说吧,你先去自己跑下 strata 推理引擎,会更新不少知识的,记得让 codex/claude 帮你优化。
|
 |
Clannad0708Oct 20
36
想啥呢...你就算部署了,智力程度,吞吐,上下文都非常拉跨
|
 |
realJamespondOct 20
37
捡垃圾 v100 16g*2 可以跑 gsq 的 27b 了模型 10g 左右
|
 |
wclebbOct 20
38
我先说我自己用 M5 Max 128G+1T ,Mac Studio ,应该符合你预算内。
( M5 Ultra 96G ,也能跑,但是能跑大模型的范围缩小到 70B 以下) DeepSeek v4.1 flash ; https://huggingface.co/unsloth/DeepSeek-V4.1-Flash-1017-GGUF 昨晚查过,我不清楚能不能跑( AI 说可以尝试,因为有部份可以在 SSD 按需读取), 但是再了解好像速度不高,我觉得下了意义不大 Nvidia 大模型 https://lmstudio.ai/models/nvidia/nemotron-3.5-super-vl 像是这个大模型,Bionic 能跑,简单问候就结束了,没有实际应用。 qwen 3.8 27B ,常见主流的大模型。 https://lmstudio.ai/models/qwen/qwen3.8-27b 你说的 qwen 3.8 27B ,稠密模型,我前段时间用来 MCP Blender ,在 M2 Max 64G Mac Studio 跑了几天,做 3D ,可用,但不高。( 128G 刚入手没有尝试) ———————— 没用过的云玩家: DGX ,64G ,128G ,CUDA 毫无争议的王者,生图生视频,跑模型一切都 OK 。 速度印象中好像单台 DGX 打不过 M5 Max 128G ,输出速率上偏低,但是有些方面各有千秋。 例如 &t=40s ———————— 近期的可选 Windows 笔记本,例如 3.8 达不溜,华硕新出的 Windows on ARM ,Nvidia 联合出品,跟 DGX 一样的芯片,但速率严重偏低,如果不喜欢且不看好 Mac ,WinOnARM Nvidia 也不错。 不过初期上市,大量的兼容性也是个问题,所以需要自己留意。 |
 |
sentinelKOct 20
39
我目前的机器市场价是 8 万左右。rtx pro 5000 48GB + 128GB DDR5 6000
目前的性能是 strata 跑 qwen3.8-flash-next-nvfp4 ,prefill4000 ,decode 130 。256k 上下文能温 5 个会话。 sglang 跑 qwen3.8-27B-nvfp4 ,256k 上下文,4 并发,配合 Hicache 能热 3~4 个会话。单路 decode 120 ,prefill 5500 到 3000 。 |
 |
anyutianminOct 20
40
qwen3.8 的哪个模型? 27b 的话,最便宜的方案应该是 170hx ,解锁的 64G ,现在涨价了,2W ,配个垃圾的 U ,16G 内存,差不多 2.5W 搞定,开 MTP 应该能达到 60 多 TPS ,够一两个人一起用爽了;不过这卡没有 NV 的质保,差不多价格的话,上 4090 ,现在快 3W 了,应该能刚好达到 3W 以内的要求,不过只能上 fp4 量化的版本。
3.8 flash 的话,用 fp4 量化也能上,也是一张卡。 如果要上 ds v4.1 的话,七百多 B 的参数量,其实已经不能算 flash 这一档的模型了,五百多 G 的显存,如果都用显存跑的话,基本得八卡才行。不过看场景,如果只是要部署对 tps 没有要求,用内存甚至 SSD 跑的方案会便宜很多;不过基本是没法用;其实这种更推荐上 ds v4 flash 或者 glm 5.3 flash ,不知道 m3.1 flash 多大,部署这些模型反而更划算。 |
 |
ntdllOct 20
41
上限 5 万,可以放弃了。
非要跑只能是量化模型,量化到流口水的那种。能用,但肯定说不上好用。 |
 |
ShadowPowerOct 20
42
https://cyberq.tw/2026/10/18/deepseek-v41-flash-1017-dual-machine-dgx/
有一篇双 dgx 跑 deepseek v4.1 flash 1017 的测试 |
 |
nexuszjqOct 20
43
跑不量化的版本至少得 20 个 w 吧
|
 |
keshawnvanOct 20
44
低预算本地能跑起来速度也满足不了需求的
|
 |
strobber16Oct 20
45
50
|
 |
CyouYamatoOct 20
46
你这预算只能买 dgx spark 用单台跑最新的 qwen3.8flash nvfp4 量化,ds flash 那建议 10 万以上的预算再考虑
|
 |
hashtagOct 20
47
两个 3090 配 ddr4 ,12 代 u 这种组合怎么样,搞搞 strata 不知道行不行
|
 |
hugowangnzOct 20
48
看看最新的 RTX Spark ?我昨天看影视飓风用这个测试了一下 qwen 一个 125B 的模型,能达到 40tokens/s 的速度,当然具体是几位量化我没看到;价格三万多到四万多吧
|
 |
ala2008Oct 20
49
一分钟回复一次?那没意义
|
 |
oldlampOct 20
50
https://mp.weixin.qq.com/s/L2LcEMOrHCl1qFpWZob08Q
用不同量化规模,可能就配置不一样,如果有的人把量化过度污名化,恐怕也有点儿过分 参考网上的配置,我测试过 5060ti 16G +64G ( 32G*2 ),也能达到 50tokens/s 以上,而且用的是 IQ3S 的,感觉也不算多笨。 |
 |
ETiVOct 20
52
DGX Spark ,现在不到 5 万
https://mia-ai.net/models?for=spark%3A1 单台 DGX Spark 能跑这些模型,DeepSeek 得 2 台 举例的话,可以看这个页面,有 Tok/s 的具体表现 https://mia-ai.net/models/Qwen3.8-Flash-Next-Single-DGX-Spark-TensorFold |
 |
louis16sOct 20
53
上下文太小,带宽太小都没什么玩的必要
|
 |
heleiOct 20
55
10 万左右勉强能用
|
 |
wwhcOct 20
56
三块/四块 3060 12gb 就够跑 Qwen3.8 27B Q5/Q6 200k+上下文了。但你需要能找到支持 3/4 个至少 pci-e x8 的主板
|
 |
jiayouzlOct 20
57
哈哈哈哈哈 3 万 5 万的配置跑这些大模型?你咋想的?
|
|
JerningChanOct 20
58
@kerwin1874 哈哈哈哈,上个越狱版,不嫌慢,估计一段段的做些小视频也可以啊,哈哈哈哈,先写好小 h 书,再生视频😂
|
 |
liuylOct 20
59
不是公司出钱就没必要,订阅省钱的多。而且现在新模型出的这么快,买硬件很快跟不上了
|
 |
moonvstodOct 20
60
两台 dgx ,大概 7.5~8 万元,可以跑满血 ds flash 4.1
|
 |
coefuOct 20
61
千万不要本地部署,3w 买 Claude API 多好。
|
 |
connor123Oct 20
62
@duanxianze #9 加 2 个 0 ,三百万都不够?这么贵的?
|
 |
LighferOct 20 via Android
63
4 卡 5090 跑 27B NVFP4 ,上下文 256K ,大概可以支撑 15 到 20 和并发请求,偶发卡顿但是还是能用
|
|
duanxianzeOct 20
64
@connor123 要是原价能买,那够了,但是原价买不到,需要各种加价,就不太够了
|
 |
jianyunetOct 20
65
strata 真是革了好多人的命还不自知
|
|
mzotw2babmOct 20
66
@wises #35 可以的,学习了。虽然感觉 strata 解决不了楼主的问题,但确实让我学到了。我准备去试试
|
 |
firemeteorOct 20 via Android
69
24G 卡+32G 主存能跑 qwen3.8 flash next IQ2_s 量化。推理速度能到 60TPS 左右,但是模型本身用起来恼火,不知道是不是量化过头了。感觉反应有点神经质...
|
 |
chengiriOct 20
70
NVIDIA RTX Spark ,需要权重压缩,有精度损失,记忆表放 ssd
|
 |
baihaihui01Oct 20
71
dgx spark ,可以跑 4.0 flash 。 上下文需要缩小一下,github 上有开源项目。之前 3.3w 一台。
|
 |
SayHelloHiOct 20
72
|
 |
recordnowOct 20
73
刚发布的极摩客 EVO-X5Pro,AI MAX+ PRO 495,192G 统一内存,价格 46999,还可以多台级联。
Q4 量化 DeepSeek V4 Flash(284B)和 GLM-5.3-Flash(320B),Qwen3.8 Flash Next |
 |
VaspikeOct 20
74
32b 以下 macbook/mini 就能跑
更高的我就不清楚了 |
 |
davinci21sOct 20
75
strata + 3090 +32G 内存 = 1.1 万,加了 32G 内存可以跑更大模型
qwen3.8 flash-next-iq3_s 60t/s 以上,经常 100 多 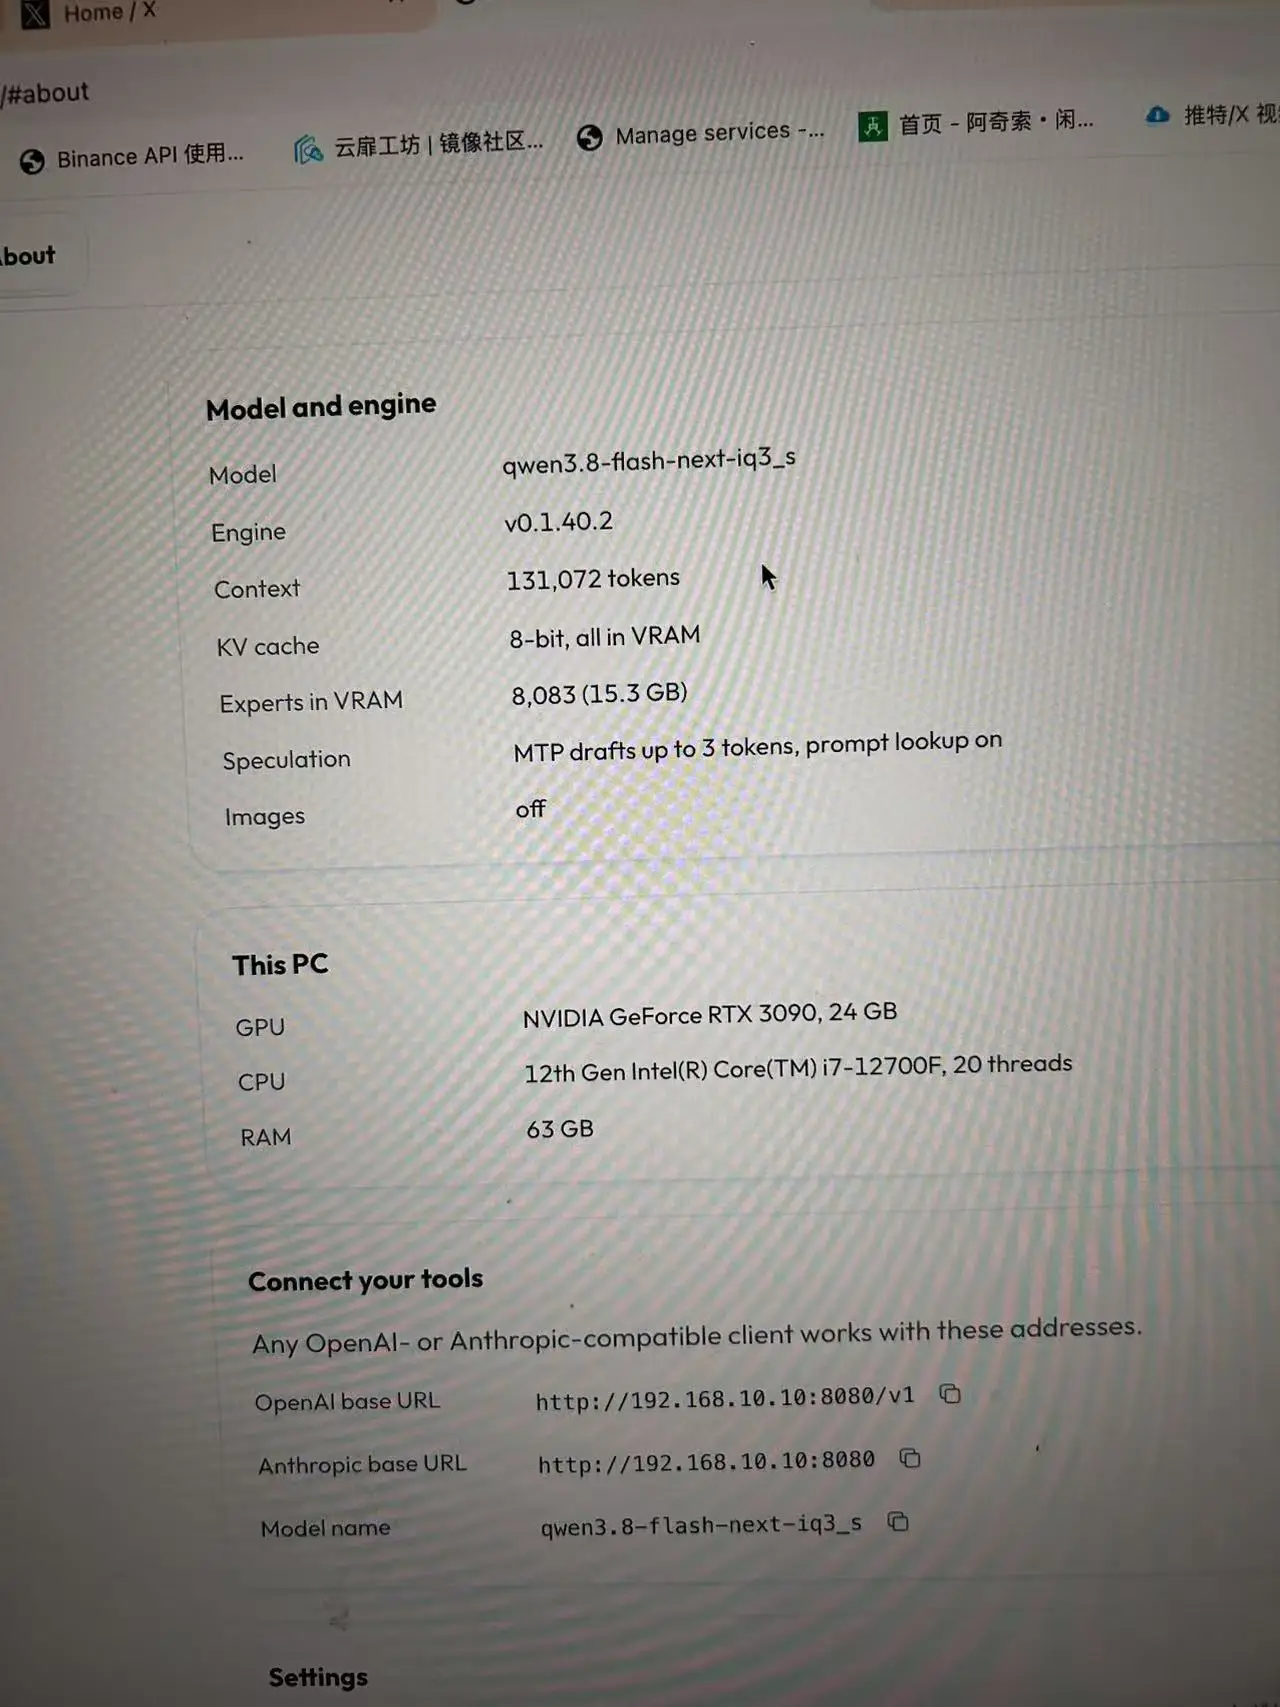 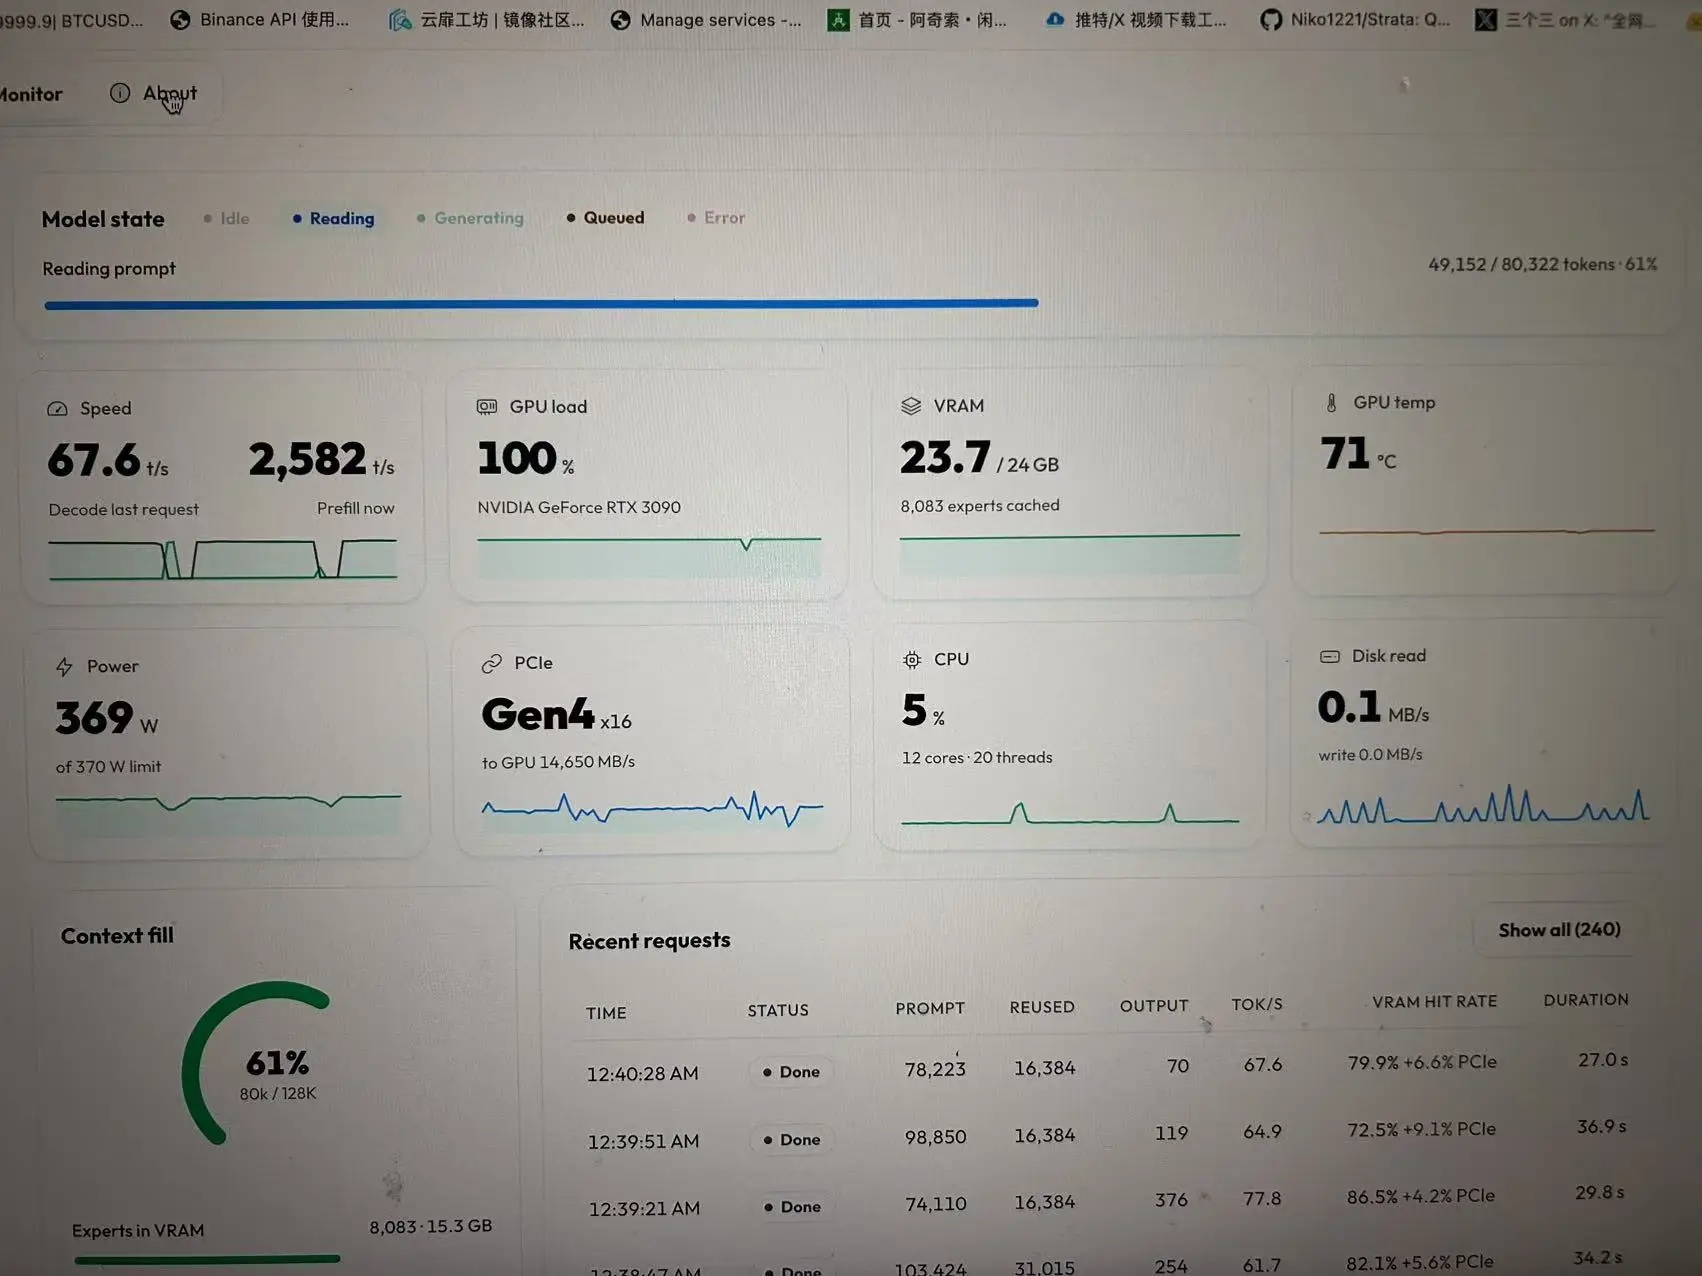 |
 |
levnOct 20
76
要超越 gpt-6.1-sol 的速度似乎并不困难
|
 |
JCZ2MkKb5S8ZX9pqOct 20
77
买不如租啊
|
 |
jetttttOct 20
79
qwen3.8-flash-next 可以看下 AMD 的 AI Max+ 395, 现在有些专用的推理引擎比如说 gufo, halogen, rulith, decode 速度能到 40+。这个机器目前看两万左右,买 128G 的
|
 |
hellskofOct 20
80
|
 |
MoatkonOct 20
81
拿 1 万出来来买 api ,都能用很久了,而且是最新的模型。买机器只是硬件又不能更新,限制很大
我以前也想买硬件,算了一笔账,算了 |
 |
smoothseaOct 20
82
跑 qwen3.8 27b 并不需要多贵的配置
|
 |
xiumingOct 20
83
让硬件在发展几年吧
|
 |
fox0001Oct 20 via Android
84
问过某宝的服务器卖家,说是华为服务器 30 万可以部署
|
 |
QuetalocatlOct 20
85
單台 DGX Spark 跑 Qwen 3.8 flash 兩台跑 DeepSeek V4.1 Flash 1017 或者 GLM 5.1 Flash ,一般 Qwen 3.8 flash 比較實際,真要求智力和速度肯定是官方 API 最好
|
 |
peyppicpOct 20
86
我持有 6x dgx spark 。其中 4 台 可以直接环形串联 运行 TP4 deepseek 1017 ,单流散文 80 左右,prefill 6K 上下。KV Cache 4M (应该还有扩大空间)
上下一个 TP2 上破甲模型 |
|
firemeteorOct 20 via Android
87
@davinci21s 你引用的数字是 32G 还是额外加了内存跑出来的?
|
 |
WhatIfOct 20
88
https://github.com/MiaAI-Lab/DeepSeek-v4-Flash-DSpark-2x-DGX-Spark
两台 dgx spark 当前狗东价格 99500 就可以拥有 qwen3.8 flash next 的话 就简单多了 , 我手头一台 ai max 395 128G 版本 单流平均 50-60 , 双卡 2080ti 22g ,64G ddr 2400 , 用 strata 感觉差不多,略高 10 个 token 吧,不过我是压低功耗运行的 250w 限制到 180w 运行。 qwen3.8 27b 的话 ,ai max 就别指望了, 速度 25-30 十分感人,完全不适合用,2080ti 的机器 fp8 权重下,速度不错, 最高 130 多。 |
 |
catazshadowOct 20
89
RDNA2 的卡都能 50 tps decode, prefill 1100
|
 |
mengduOct 20
90
骗币达人。
|
|
davinci21sOct 20
91
@firemeteor 都差不多,64G 也没提高多少
|
 |
royoOct 20
92
ds-v4.1-flash 即便部署自己用,也得十万 rmb 左右。如果没有保密要求,api 划算的多。
|
 |
linuslvOct 21
93
能跑和能用是两回事
|
 |
flyicoOct 21
94
不要盯着最低需求骗自己了,能吐字和能流畅的吐字完全是两个产品
|
 |
95
预算 3~5 万如果要落地跑起来,关键是看你的真实业务场景和对并发/上下文的需求:
1. 如果是单人使用、写代码或分析长文档,强推 Qwen 3.8 Flash Next (或 27B 的量化版本): 现在的推理生态有了很大变化,配合类似 Strata 、ninfer 这类针对特定硬件高度优化的专精引擎( Overfit Inference Engines ),在 24G~48G 显存(如双 3090/4090 或二手专业卡)+ 64G/128G 高速内存的机器上,分层卸载跑 IQ3_S / NVFP4 ,decode 已经能做到 60~100+ tps ,且能保持 128k~256k 的可用上下文,体验相当丝滑,整机预算 2~3 万完全能打住。 2. 如果目标是 700B+ 级别的 DeepSeek V4.1 Flash: 4.1 参数量和 KV cache 开销比上一代膨胀不少,单台哪怕是 128G 统一内存机器跑起来吞吐也会非常吃力(几 tps 到十几 tps 只能算“能吐字”,无法支撑生产 vibecoding 或批量数据建模)。真要本地满血跑,通常需要 2 台以上 DGX Spark 或多卡集群级联,5 万预算确实会非常局促。 3. 真实落地踩坑建议: 我自己做开源自托管 Agent ( openmuse-standalone ,声明我是开发者),实际折腾下来最深的体会是:本地部署千万不要盲目硬上顶配大模型而牺牲推理速度。小团队和个人 vibecoding / 数据分析场景下,用 2~3 万搞一套“24G/48G 显存 + 128G 内存 + 专用专精引擎”跑 27B~125B 甜点级模型,响应快、上下文不超载,配合轻量上下文裁剪与精准 Tool Call ,生产力远比在极限硬件上卡顿跑超大模型高得多。如果确实遇到极少数极高难度的推理任务,偶尔打一下云端商业 API 补位,是性价比最高且体验最稳定的架构方案。 |
 1


 Select Language