
制作了这样一个 Windows 上的小工具,用于提取字幕。
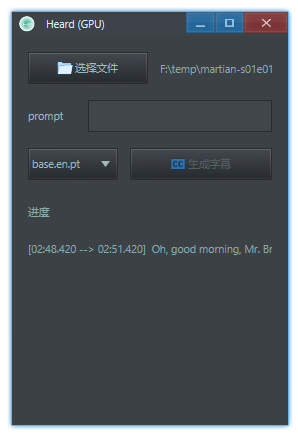
生成的字幕还可以离线英文翻译为中文:

制作了这样一个 Windows 上的小工具,用于提取字幕。
生成的字幕还可以离线英文翻译为中文:
 |
GreenmMar 29, 2023
1
楼主的我没用过,但是同样有一个 windows 上基于 whisper 的竞品: https://github.com/chidiwilliams/buzz
|
 |
renmuMar 29, 2023 via Android
3
提点可能能做出差异化的东西。
其实你可以支持点别的东西,比如 whisperx ,faster-whisper ,以及一些超参数,反正你是用 Python 起得服务器来实现调用的,应该不会太麻烦。 whisper 对长音频解析的时候会经常出现多句重复的情况,可以做些简单处理。 也可以支持转成 ass 。 不同的音频可能参数会不一样,还可以支持什么参数配置加载。 ps:whisper 好像对唱歌音频效果不太好,有知道大佬吗 |
 |
wudicgiMar 29, 2023
4
赞~~~
我是半个多月前刚了解到的这个 Whisper, 还打算结合以前做过的 SpleeterMsvcExe 项目做个自动生成歌词的工具 Whisper 识别出来的字幕,时间戳对齐的不太好,虽然现在有 word aligned 参数,但加上这个参数后识别效果不如不加时的 结合 Spleeter 对音频文件先分离出 vocals 轨,再按语音强弱把字幕给对齐一下应该就有不错的效果了 |
 |
learnerMar 29, 2023
5
"whisper 对长音频解析的时候会经常出现多句重复的情况" 这个我也遇到了,大佬有什么解决办法吗?
|
|
wudicgiMar 29, 2023
7
另外有一个 whisper.cpp 的项目,可以免除 Python 环境
https://github.com/ggerganov/whisper.cpp 缺点是不支持 GPU, 启用 word aligned 参数时比官方原版的效果要差很多 |
|
9
@learner 这个从我用过几次的经验来看,换大一些的模型这种现象出现的会少一些
比如用 medium 模型,和 small, tiny 相比就不容易出这个问题 其他的因为还没具体去看它是如何对音频进行切片处理的,还不太清楚问题根源 |
|
10
简单粗暴的方法就是对解析后的 srt 再做个处理,如果前后两句重复,那么直接把后一句删了。
|
|
renmuMar 29, 2023 via Android
13
@learner 我这边的情况是在一般只有在没人说话的时候才会不断重复上一句。
你可以试试 whisperx ,好像情况会好一些,具体我没测试过 |
 |
tool2dMar 29, 2023
14
|
 |
iX8NEGGnMar 29, 2023 via iPhone
15
“生成的字幕还可以离线英文翻译为中文”,这也是 whisper 做的吗?我记得它只支持其他语言翻译成英文
|
 |
koastMar 29, 2023
16
@tool2d 繁体的问题可以通过 initial_prompt 来解决,大致是用简体中文给指示就好,在 whisper 的 issue 里有人提到过,效果挺好的
|
 |
kernelpanicMar 29, 2023
17
真复杂,又是 server 又是 npm 的,直接用这个不香吗,https://github.com/Const-me/Whisper ,不用安装,只有几百 kb 大小,再下载个模型 https://huggingface.co/ggerganov/whisper.cpp/tree/main ,直接用,还支持 GPU 加速
|
 |
18
@iX8NEGGn whisper 那个是语音翻译,这里是指使用 whisper 生成字幕后,对字幕翻译,是另一个工具了,将英文文本的 srt 文件,翻译为中文文本的 srt 文件
|
 |
hanguofuMar 30, 2023
19
请问 识别普通话的时候 ,WER 错误率很高吗 ?
|
|
20
@hanguofu whisper 官方有给一个表,中文是 14.7 ,英文是 4.2 。链接: https://github.com/openai/whisper
|
 |
candafromcnJun 14, 2023
22
@rerender 字幕翻译是用什么实现的, 网络 api 还是 AI 翻译?
|
 1
 Select Language