 MySQL 相关项目

本文旨在用最通俗的语言讲述最枯燥的基本知识
这个话题比较有意思。 昨天中午吃完饭间突然有个同事蹦出了一句:“ like 有索引吗?”,我顺口就说没有,另一个同事反驳说有啊,还有些同事说看情况的有,这下有点懵逼了,都不知道那种说法是正确的,于是决定花了个半小时来研究验证这个问题,终于得到答案。
怎么验证的呢?
坊间有传言:MySQL 性能优化有个神器,叫做 explain,它可以对 select 语句进行分析并且输出详细的 select 执行过程的详细信息,让开发者从这些信息中获得优化的思路。
下面来讲讲这个 MySQL 提供的 explain 命令:
语法:explain SQL 语句 例如:
explain select * from user where id=1
执行完毕之后,它的输出有以下字段:
- id
- select_type
- table
- partitions
- type
- possible_keys
- key
- key_len
- ref
- rows
- Extra
要想知道 explain 命名怎么使用,就必须把这些字段搞清楚
1. id
SELECT 查询的标识符, 每个 SELECT 语句都会自动分配一个唯一的标识符
2. select_type
每个 select 查询字句的类型,具体类型以及对应作用如下表: |类型名|解释| |:--:|:--| |SIMPLE|简单 SELECT,不使用 UNION 或子查询等| |PRIMARY|查询中若包含任何复杂的子部分,最外层的 select 被标记为 PRIMARY| |UNION|UNION 中的第二个或后面的 SELECT 语句| |DEPENDENT UNION|UNION 中的第二个或后面的 SELECT 语句,取决于外面的查询| |UNION RESULT|UNION 的结果| |SUBQUERY|子查询中的第一个 SELECT| |DEPENDENT SUBQUERY|子查询中的第一个 SELECT,取决于外面的查询| |DERIVED|派生表的 SELECT, FROM 子句的子查询| |UNCACHEABLE SUBQUERY|一个子查询的结果不能被缓存,必须重新评估外链接的第一行
3. table
显示这一行的数据是查哪张表的,不过有时短路显示的不是真实的表名。
4. partitions
匹配的分区(这个目前用处不大)
5. type
访问类型,表示 MySQL 在表中找到所需行的方式,对应的值和解释如下: |类型名|优级别|解释| |:--:|:--:|:--| |system|1|表仅有一行| |const|2|表最多有一个匹配行,在查询开始时即被读取| |eq_ref|3|使用 primary key 或者 unique key 作为多表连接的条件,仅从该表中读取一行| |ref|4|作为查询条件的索引在每个表匹配索引值的行从表中读取出来| |fulltext|5|全文索引检索| |ref_or_null|6|和 ref 一致,但增加了 NULL 值查询支持| |index_merge|7|表示使用了索引合并优化方法| |unique_subquery|8|使用了替换了 in 子查询| |index_subquery|9|使用了替换了 in 子查询,但只适用于子查询中的非唯一索引| |range|10|只检索给定范围的行,使用一个索引来选择行| |index|11|全表扫描,但扫描表的方式是按索引的次序进行| |ALL|12|全表扫描的方式找到匹配的行|
type 作为访问类型,其值代表着当前查询所用的类型,是体现性能的一个重要指标,从表中可以看到,从上到下,扫描表的方式越来越宽,性能也就越来越差,因此,对于一个查询,最好能保持在 range 级别以上。
6. possible_keys
主动指出查询能用哪个索引在表中找到记录 也就是会列出在查询中的字段中有索引的字段,但不一定被查询所用。
7. key
显示再查询中实际使用的索引 /键,如果没有索引,则显示 NULL。 但如果想强制查询中使用或忽视 possible_keys 列中的索引,则可以在查询中使用 FORCE INDEX、USE INDEX 或者 IGNORE INDEX。
8. key_len
表示索引中使用的字节数。
9. ref
表示哪些列或常量被用于查找索引列上的值。
10. rows
显示当前查询估算到的查找到匹配记录所需的记录行数。
11. Extra
显示当前查询所用的解决方式,它有以下几种情况: |类型名|解释| |:--:|:--| |Using where|列数据是从仅仅使用了索引中的信息而没有读取实际的行动的表返回的,| |Using temporary|表示 MySQL 需要使用临时表来存储结果集,常见于排序和分组查询| |Using filesort|MySQL 中无法利用索引完成的排序操作称为“文件排序”| |Using join buffer|改值强调了在获取连接条件时没有使用索引,并且需要连接缓冲区来存储中间结果。如果出现了这个值,那应该注意,根据查询的具体情况可能需要添加索引来改进能。| |Impossible where|这个值强调了 where 语句会导致没有符合条件的行。| |Select tables optimized away|这个值意味着仅通过使用索引,优化器可能仅从聚合函数结果中返回一行|
讲完了语法,我们来实际操作一波,首先创建个表:
-- 创建表
CREATE TABLE test(
id INT(11) NOT NULL AUTO_INCREMENT,
uname VARCHAR(255),
PRIMARY KEY(id)
);
然后给 uname 字段加上索引:
-- 添加索引
ALTER TABLE test ADD INDEX uname_index (uname);
查看一下索引是否添加成功:
-- 查看是否有索引
SHOW INDEX FROM test;
输出结果为:
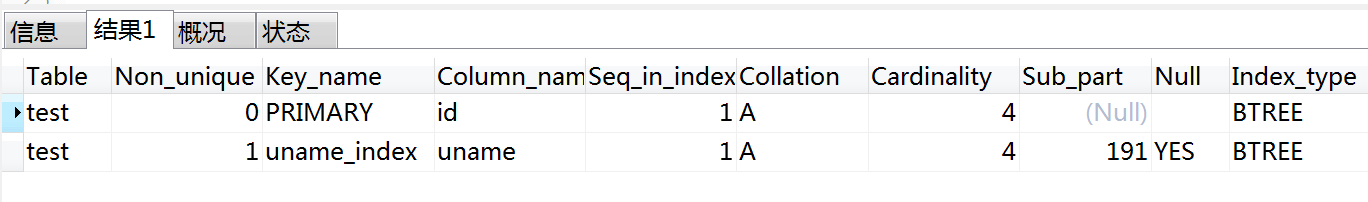 可以看出索引已经创建成功,接下来添加一些数据:
-- 添加一些数据
INSERT INTO test VALUES(1,'jay');
INSERT INTO test VALUES(2,'ja');
INSERT INTO test VALUES(3,'bril');
INSERT INTO test VALUES(4,'aybar');
一切准备就绪,下面用 explain 这个命令来探究一些 like 语句是否有索引, like 有四种情况,分别为没有%、 %% 、左%、右%、
1. like 字段名
EXPLAIN SELECT * FROM test WHERE uname LIKE 'j';
输出为:

可以看出: type 的值为:range,key 的值为 uname_index,也就是说这种情况下,使用了索引。
2. like %字段名%
EXPLAIN SELECT * FROM test WHERE uname LIKE '%j%';
输出为:

可以看出: type 的值为 ALL 也就是全表扫描,而且 key 的值为 NULL,也就是说没用到任何索引。
3. like %字段名
EXPLAIN SELECT * FROM test WHERE uname LIKE '%j';
输出为:
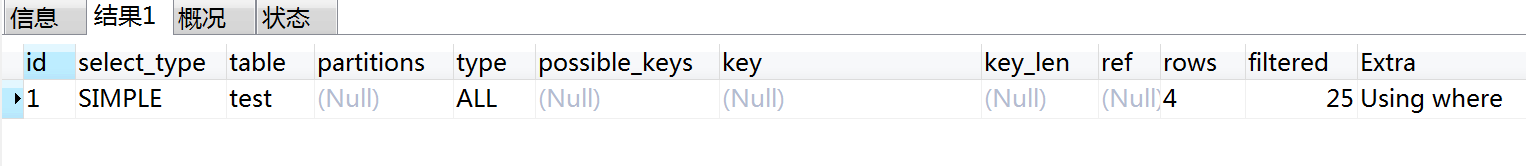 可以看出:
type 的值为 ALL,key 的值为 NULL,同样没用到索引。
4. like 字段名%
EXPLAIN SELECT * FROM test WHERE uname LIKE 'j%';
输出为:
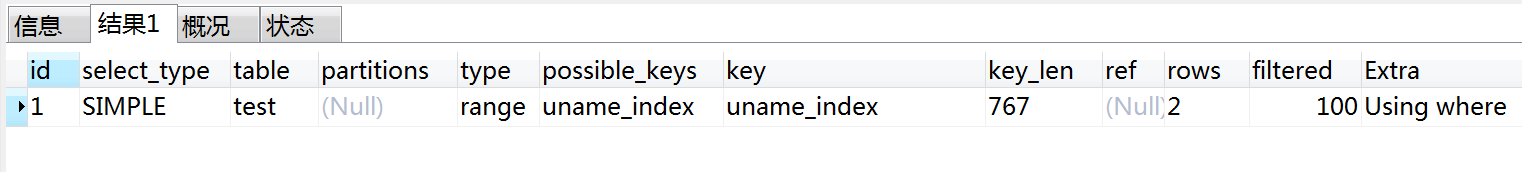 可以看出:
type 的值为:range,key 的值为 uname_index,也就是说这种情况下,使用了索引。
总结
由上面的试验可以总结出 like 是否使用索引的规律: like 语句要使索引生效,like 后不能以%开始,也就是说 ( like %字段名%) 、( like 字段名%)这类语句会使索引失效,而( like 字段名)、( like 字段名%)这类语句索引是可以正常使用。
其它
为了查证 like 索引的问题,研究了 MySQL 神奇 explain,但 explain 不仅仅只能检查索引使用情况,还可以提供很多其它的性能优化方面的帮助,至于具体的使用,其实跟上面讲的一样,把 explain 结果列出来,然后顺藤摸瓜查阅相关的字段就可以得到相应的内容。
觉得本文对你有帮助?请分享给更多人 关注「编程无界」,提升装逼技能
 Select Language